
Lakehouse para exportadoras: una única fuente de verdad para ventas, stock y cobranzas

Lakehouse para exportadoras: una única fuente de verdad para ventas, stock y cobranzas El costo de operar con datos fragmentados en exportación Cuando una empresa exportadora argentina cierra un trimestre, el CFO consolida el Excel de cobranzas en dólares, el responsable de logística actualiza el stock desde el WMS, y el área comercial exporta el reporte de ventas del ERP. Tres archivos, tres criterios distintos de fecha de corte, dos tipos de cambio diferentes. El resultado: ningún número cuadra y la reunión de directorio se convierte en un debate sobre cuál planilla es la correcta, no sobre qué decisión tomar. Este escenario es habitual en gran parte de las organizaciones exportadoras argentinas. Según un informe de CEPAL sobre PyME exportadoras (2021), la dificultad para acceder y procesar información comercial es una de las restricciones críticas para competir en mercados externos, especialmente cuando los compradores internacionales exigen trazabilidad, fill rates documentados y términos de pago verificables. Este artículo explica, con detalle técnico y sin rodeos, cómo una arquitectura Lakehouse con modelo Medallion más una capa de modelos semánticos y métricas calculadas resuelve ese problema de raíz para equipos que operan con fuentes heterogéneas y presupuestos acotados. Por qué Lakehouse y no solo un data warehouse tradicional Un data warehouse tradicional obliga a definir el esquema antes de ingerir datos. Para una PYME exportadora que tiene un ERP local (Tango, SAP Business One o incluso Bejerman), un sistema de gestión de exportaciones separado, un WMS propio o de terceros y cobranzas parcialmente en el banco y parcialmente en planillas, esa rigidez se traduce en meses de modelado antes de ver el primer reporte. Un Lakehouse combina la flexibilidad de un data lake (ingestión de cualquier formato, sin esquema previo obligatorio) con las capacidades de consulta y gobernanza de un warehouse. Plataformas como Azure Synapse Analytics, Databricks, Snowflake o BigQuery implementan este patrón de forma nativa. Azure Databricks, por ejemplo, documenta la arquitectura Medallion como patrón recomendado para crear una única fuente de verdad empresarial, con datos refinados progresivamente hasta la capa Gold para consumo analítico. El volumen global de datos pasó de 64,2 ZB en 2020 a 181 ZB en 2025, casi el triple en cinco años (Forbes, citado por Bismart, 2023). Las organizaciones que no tienen una arquitectura diseñada para escalar la ingestión y el procesamiento van a pagar ese crecimiento con deuda técnica acumulada. El Lakehouse con enfoque Medallion se ha consolidado como estándar en grandes organizaciones para analítica avanzada y ML, y su costo de adopción bajó lo suficiente como para ser viable en PYME con infraestructura cloud moderada. Takeaway: El Lakehouse no es sobreingeniería para una PYME exportadora; es la única arquitectura que permite ingerir datos sucios hoy y gobernarlos progresivamente sin tirar el trabajo cuando cambia el ERP o se suma un nuevo mercado. Capa Silver: calidad, estandarización y joins por dominio En Silver se aplican las reglas de negocio comunes: normalización de monedas (tipo de cambio oficial, MEP o CCL según corresponda), unificación de códigos de producto entre el ERP y el WMS, deduplicación de cobranzas y estandarización de fechas de vencimiento según Incoterm. Un patrón efectivo es organizar Silver en tres dominios separados pero linkables: Dominio Ventas: fact_sales_orders con granularidad a nivel línea de pedido, moneda original y convertida, mercado de destino, vendedor y canal. Dominio Stock: fact_inventory_movements con SKU normalizado, ubicación en depósito, estado (disponible, reservado, en tránsito) y valorización al costo estándar. Dominio Cobranzas: fact_receivables con número de factura de exportación, fecha de vencimiento, estado, días de mora y monto pendiente en divisa original. La clave en Silver es que las transformaciones son reproducibles y auditables. Usar dbt (data build tool) para modelar esta capa permite versionar cada regla de negocio en Git, documentar lineage y detectar breaking changes automáticamente cuando cambia el ERP. Capa Gold: modelos orientados a dominio para analítica Gold es donde los datos dejan de ser registros y se convierten en información de negocio. Aquí se construyen los modelos dimensionales que consumen Power BI, Looker o cualquier herramienta de visualización. El patrón documentado por proveedores como Decide Soluciones muestra que en Gold se consolidan datos de distintas áreas en modelos específicos por proyecto o área de negocio. Para una exportadora, Gold incluye típicamente: dim_customer con jerarquía país, región, agente comercial y clasificación de riesgo crediticio dim_product con categoría, posición arancelaria y costo de producción fact_export_performance que cruza ventas confirmadas, stock comprometido y cobranzas pendientes por cliente y período Takeaway: Cada capa del Medallion tiene una responsabilidad única. Mezclar transformaciones de Silver y Gold en el mismo proceso es el error más frecuente y el que genera modelos imposibles de mantener cuando el negocio cambia. Modelos semánticos y métricas calculadas: el puente entre el dato y la decisión Una capa Gold bien construida no es suficiente si cada área calcula sus propias métricas en el informe de Power BI. El modelo semántico, implementado en Power BI (modelo tabular) o en dbt metrics / Looker LookML, define las métricas una sola vez y las expone de forma consistente a todos los consumidores. Las métricas críticas para una PYME exportadora argentina son: Fill Rate: porcentaje de líneas de pedido despachadas en tiempo y forma sobre el total comprometido. Se calcula cruzando fact_sales_orders con fact_inventory_movements en la fecha de ship date acordada. DSO (Days Sales Outstanding): días promedio de cobro = (cuentas por cobrar / ventas del período) × días del período. Una métrica DAX en Power BI que se actualiza diario desde Gold evita que cada analista use un denominador diferente. Margen por mercado: precio de venta FOB menos costo de producto más flete y aranceles, expresado en USD, segmentado por país de destino. Stock de seguridad por SKU exportable: stock disponible menos stock comprometido en órdenes abiertas, comparado contra el lead time de reposición. En Power BI, estas métricas se centralizan en un modelo semántico publicado en el servicio (antes llamado dataset certificado) al que se conectan múltiples reportes. Si la fórmula del DSO cambia por política financiera, se actualiza
RPA vs Agentes de IA con n8n: ROI comparativo 2026 para pymes B2B en EE. UU.
RPA vs Agentes de IA con n8n: cuándo conviene cada enfoque según el ROI 2026 Un análisis 2025-2026 sobre automatización de procesos con n8n y agentes de IA reportó un ROI promedio del 330%, una reducción del 65% en tiempos de proceso y una mejora del 85% en satisfacción del cliente. Frente a esos números, el RPA tradicional, que sigue siendo valioso, muestra limitaciones estructurales que no se resuelven con más bots ni más reglas. Este artículo compara ambos enfoques con datos concretos, examina cuándo cada tecnología entrega mejor retorno y propone un marco de decisión para equipos de operaciones y dirección de TI que evalúan inversiones en automatización de back-office durante 2026. RPA clásico: ejecución determinista sobre interfaces fijas Los bots RPA, como los que se implementan con UiPath, Automation Anywhere o Power Automate Desktop, replican acciones humanas sobre interfaces de usuario: copiar datos de un portal, pegar valores en un ERP, generar un PDF desde una plantilla. Su fortaleza es la precisión en tareas 100% estructuradas y repetitivas donde el flujo no cambia. Su debilidad es exactamente la misma: cuando el flujo cambia, el bot falla. Cada excepción requiere intervención humana o reprogramación. En procesos de back-office B2B con alta variabilidad, como validación de facturas con formatos distintos por proveedor, gestión de disputas de pago o clasificación de solicitudes de soporte, el mantenimiento de bots RPA puede consumir entre el 30% y el 40% del ahorro inicial en horas de TI y correcciones. Agentes de IA orquestados con n8n: razonamiento + acción sobre múltiples sistemas Un agente de IA orquestado con n8n combina modelos de lenguaje (como GPT-4o o Claude 3.5) con herramientas de acción: puede leer un correo electrónico en Gmail, extraer datos de una factura PDF, consultar el estado de un pedido en HubSpot o NetSuite, tomar una decisión condicional y registrar el resultado en Airtable, todo dentro de un mismo flujo sin intervención humana. La diferencia clave es que el agente interpreta contexto; no solo sigue reglas. Eso permite manejar excepciones, documentos semi-estructurados y decisiones de baja complejidad que antes requerían un empleado o rompían el bot RPA. Takeaway: Si los procesos de back-office involucran múltiples aplicaciones, formatos variables o excepciones frecuentes, el agente de IA con n8n tiene ventaja estructural desde el diseño. El problema de los datos fragmentados: el factor que define el ROI real El estudio global de Snowflake 2026 reveló que el 64% de las organizaciones tiene dificultades para integrar datos en silos, y solo el 11% declara que sus datos no estructurados están listos para IA. Este dato es crítico para cualquier PYME que evalúe automatización: ni el RPA ni los agentes de IA funcionan bien sobre datos fragmentados entre CRM, ERP, correo electrónico, contabilidad y soporte. Sin embargo, los dos enfoques reaccionan de forma diferente ante esa fragmentación. Un bot RPA requiere que los datos ya estén en el formato y la ubicación esperados; cualquier variación rompe el flujo. Un agente de IA con n8n puede conectar fuentes heterogéneas mediante APIs, webhooks y nodos nativos de integración, normalizando datos al vuelo antes de procesarlos. Para organizaciones que operan con Salesforce + QuickBooks + correo + hojas de cálculo sin un lago de datos centralizado, la arquitectura de agente resulta más tolerante a la realidad operativa típica de una PYME B2B en Estados Unidos. Takeaway: Antes de elegir tecnología, el equipo de TI debe mapear cuántos sistemas fuente involucra cada proceso y cuánta variabilidad existe en los datos de entrada. Ese mapeo define qué enfoque es viable sin inversión adicional en limpieza de datos. Comparativa de ROI por tipo de proceso back-office No todos los procesos responden igual a cada tecnología. El siguiente resumen sintetiza los hallazgos más relevantes para equipos de operaciones que deben priorizar dónde invertir primero. Conciliación bancaria masiva con formato fijo: RPA conserva ventaja; alto volumen, bajo costo de implementación, mantenimiento predecible. Validación y aprobación de facturas de proveedores con múltiples formatos: Agente de IA con n8n supera al RPA en reducción de errores y tiempo; maneja PDFs no estandarizados sin reprogramación. Enrutamiento y respuesta inicial de solicitudes de soporte B2B: Agente de IA con n8n es superior; clasifica, prioriza y responde con contexto del CRM en tiempo real. Generación de reportes desde un ERP con estructura estable: RPA cumple a bajo costo; estructura fija elimina la necesidad de razonamiento. Calificación y seguimiento de leads entrantes de múltiples canales: Agente de IA con n8n; conecta formularios web, LinkedIn y correo en un único flujo con decisión de prioridad. Onboarding de nuevos clientes con documentación variable: Agente de IA con n8n; extrae, valida y registra datos independientemente del formato del documento. Según datos atribuidos a empresas que ya integraron agentes de IA en su operación, publicados en 2026, se registró una reducción media del 35% en tareas administrativas repetitivas y un aumento del 28% en leads cualificados, resultados que el RPA clásico no logra sin módulos de IA adicionales. Takeaway: El RPA sigue siendo la opción correcta para procesos de alto volumen y estructura fija. Para todo lo que involucre decisión, contexto o variabilidad, los agentes de IA con n8n generan retorno superior con menor costo de mantenimiento a largo plazo. Gobernanza y control: el requisito que no es opcional El estudio de Snowflake 2026 también documentó que el 92% de las organizaciones pioneras en IA generativa reportaron haber amortizado su inversión, con un rendimiento promedio del 41%. Pero ese resultado no fue automático: la gobernanza fue un denominador común en los casos exitosos. Para una PYME, gobernanza no significa burocracia. Significa definir con precisión qué puede ejecutar el agente de forma autónoma, qué requiere aprobación humana y cómo se registran las decisiones para auditoría. En n8n, esto se implementa con nodos de validación, registros en bases de datos como PostgreSQL o Airtable, y alertas automáticas en Slack o correo cuando el agente detecta una excepción fuera de su umbral de confianza. Sin estos controles, la autonomía del agente se convierte en riesgo operativo. Con ellos, la
Agentes de IA como empleados digitales en backoffice: resultados medidos en EE. UU. 2025-2026

Agentes de IA como empleados digitales en backoffice: resultados medidos en EE. UU. 2025-2026 El backoffice como primer laboratorio de los agentes de IA El 27% de las organizaciones ya despliega agentes de IA en departamentos concretos, y otro 28% se encuentra en fase experimental, según datos sectoriales de 2025-2026. Eso significa que más de la mitad del mercado B2B está probando o ejecutando lo que muchos directores de operaciones llaman empleados digitales: sistemas de IA capaces de operar CRMs, ERPs y herramientas SaaS sin intervención humana constante. En Estados Unidos, la discusión se concentra en dónde desplegar esta tecnología primero con resultados medibles. La respuesta más consistente en 2025-2026 apunta a un lugar específico: el backoffice. Facturación, conciliación contable, onboarding de clientes, alta y baja de proveedores, soporte interno de nivel 1 y reporting financiero recurrente son los procesos donde los agentes están demostrando impacto cuantificable antes de tocar cualquier función de cara al cliente. Qué significa realmente un «empleado digital» en este contexto El término empleado digital no es metáfora de marketing. Describe un agente de IA con capacidad de tomar decisiones dentro de límites definidos, ejecutar acciones en sistemas externos y registrar cada paso para auditoría. En la práctica operativa de 2026, esto implica una arquitectura de tres capas que combina tecnologías distintas con roles distintos. La arquitectura operativa del backoffice con IA: n8n + RPA + LLM Quienes han llevado agentes a producción en 2025-2026 suelen seguir un patrón técnico consistente. n8n actúa como capa de orquestación y logging: gestiona el flujo de trabajo, conecta APIs, CRM, contabilidad y helpdesk, y registra cada transacción del agente. Un modelo de lenguaje grande (LLM) ocupa la capa de decisión: interpreta contexto, prioriza acciones y genera respuestas estructuradas. RPA tradicional cubre la ejecución en sistemas legados donde no existe API disponible; es la capa que «hace clic» en pantalla cuando el entorno lo requiere. Este modelo híbrido resuelve una limitación práctica frecuente en empresas en crecimiento: los sistemas heredados no exponen APIs modernas, pero tampoco pueden reemplazarse en el corto plazo. El RPA extiende el alcance del agente sin exigir una reingeniería del stack tecnológico existente. Takeaway: antes de diseñar un agente, el equipo de TI debe mapear qué sistemas tienen API y cuáles requieren RPA, porque esa distinción determina el costo y el tiempo de integración. Resultados medidos en backoffice: qué dicen los datos de 2025-2026 Las consultoras y empresas de software que publicaron resultados verificados en 2025-2026 reportan reducciones de costos del 30% al 50% y comprensión del tiempo de ejecución en tareas estructuradas del 70% al 90% al desplegar agentes de IA en flujos complejos de backoffice. Estos rangos no son promedios teóricos; provienen de despliegues reales en organizaciones que automatizaron procesos con ciclos repetitivos y alta dependencia de datos estructurados. A nivel corporativo, CEMEX, empresa B2B industrial de referencia, desplegó un agente de IA para acelerar la toma de decisiones ejecutivas integrando datos operativos y financieros en tiempo real. El caso ilustra que la lógica del empleado digital aplica tanto a grandes corporaciones como a PYMEs: la diferencia está en la escala del despliegue, no en la viabilidad del modelo. La proyección de Gartner para finales de 2026 es relevante como señal de mercado: el 40% de las aplicaciones empresariales incorporará agentes de IA, frente al 5% registrado en 2025. Esa aceleración de 8x en menos de dos años indica que las organizaciones que no inicien pilotos estructurados en 2025 enfrentarán una brecha competitiva operativa, no solo tecnológica. Los seis procesos de backoffice con mayor madurez de automatización Facturación y cobros: el agente genera facturas desde el CRM, las envía por email automatizado y actualiza el estado en el ERP sin intervención manual. Conciliación contable: cruza transacciones bancarias con registros del ERP, identifica discrepancias y escala solo los casos que superan umbrales predefinidos. Onboarding de clientes: valida documentación, crea registros en CRM y ERP, y dispara flujos de bienvenida coordinados entre ventas, legal y operaciones. Alta y baja de proveedores: recopila formularios, verifica datos fiscales, activa cuentas en el sistema de compras y notifica a los equipos correspondientes. Soporte interno de nivel 1: responde consultas de empleados sobre nómina, beneficios o TI utilizando bases de conocimiento conectadas; escala a humano solo cuando el caso lo requiere. Reporting financiero recurrente: extrae datos de múltiples fuentes, consolida métricas clave y distribuye reportes a dirección según calendario predefinido. Takeaway: estos seis procesos comparten una característica fundamental: son repetitivos, tienen reglas explícitas y producen datos auditables. Son exactamente el tipo de trabajo donde un agente supera al humano en velocidad y consistencia. Los dos obstáculos que frenan el paso de piloto a producción Los datos sectoriales revelan una tensión crítica: solo el 14% de las empresas logra despliegues a escala organizativa. La mayoría permanece en pruebas departamentales. Identificar por qué ocurre esto es tan importante como conocer los beneficios potenciales. Obstáculo 1: calidad y gobernanza de datos Muchas organizaciones B2B operan con CRMs y ERPs donde más del 30% de los campos críticos están vacíos o contienen datos inconsistentes. Un agente de IA que opera sobre datos incompletos no solo pierde precisión; puede generar errores en backoffice con consecuencias financieras directas, como facturas con importes incorrectos o conciliaciones fallidas que requieren corrección manual costosa. La gobernanza de datos no es un proyecto paralelo a la implementación de agentes; es una precondición. Los equipos de operaciones que saltan esta etapa descubren el problema en producción, cuando el costo de corrección es significativamente mayor. Obstáculo 2: ausencia de criterios de escalado desde el inicio Los pilotos exitosos suelen diseñarse para un departamento específico con un conjunto acotado de variables. El problema aparece cuando la organización intenta replicar ese piloto en otros procesos sin haber documentado las condiciones que lo hicieron funcionar. Sin un diseño modular desde el inicio, cada nuevo despliegue requiere casi tanto esfuerzo como el primero. Las organizaciones que superan el 14% de éxito en escalado comparten un patrón: definen desde la fase de diseño qué componentes del
Agentes de IA con n8n para seguimiento de leads y cotizaciones en pymes españolas
Agentes de IA con n8n para el seguimiento de leads y cotizaciones en empresas españolas El 89% de los directivos españoles planea usar agentes de IA en ventas; menos del 2% lo ha hecho bien Según el Índice de Tendencias Laborales 2025 de Microsoft, el 89% de los directivos españoles planea desplegar agentes de IA en los próximos 12 a 18 meses, especialmente en atención al cliente, marketing y ventas. Al mismo tiempo, datos del Ministerio de Economía indican que apenas el 2% de las pymes españolas y europeas utiliza agentes virtuales o chatbots para interactuar con clientes de forma automatizada. Esa distancia entre intención y ejecución tiene menos que ver con el presupuesto disponible o la voluntad de los equipos que con la arquitectura técnica sobre la que se apoyan los procesos comerciales. Dentro del ciclo comercial B2B, esa brecha se concentra con especial intensidad en el seguimiento de leads y la gestión de cotizaciones. Un lead entra por correo electrónico o formulario web, alguien lo registra manualmente en HubSpot o Zoho CRM, otro miembro del equipo redacta una propuesta y, tres días después, el prospecto ya está hablando con la competencia. Este artículo describe cómo los agentes de IA orquestados con n8n pueden cerrar ese hueco operativo de forma medible. Por qué el seguimiento manual destruye oportunidades en el ciclo comercial B2B El proceso comercial en una empresa de servicios o industria B2B sigue un patrón previsible: captura de contacto, cualificación, cotización, seguimiento y cierre. Cada transición entre etapas depende, en la mayoría de los casos, de acciones manuales. El resultado es predecible: leads sin respuesta en más de 48 horas, cotizaciones enviadas sin seguimiento posterior y equipos comerciales que dedican entre el 30% y el 40% de su tiempo a tareas administrativas en lugar de vender. El Banco de España estima que casi el 20% de las empresas españolas ya emplea algún sistema de IA, pero la mayoría lo hace de forma experimental y concentrada en optimización interna o marketing, no en el ciclo de ventas end-to-end. La encuesta TIC del INE, citada por Cotec, confirma que el uso de IA en empresas españolas de diez o más empleados saltó del 12,4% en 2023 al 21,1% en 2024; un crecimiento significativo que, sin embargo, todavía no se traduce en automatización del seguimiento comercial. El coste de inacción es concreto: cada oportunidad sin seguimiento en menos de cuatro horas reduce la probabilidad de conversión en un porcentaje que múltiples estudios de ventas B2B sitúan por encima del 50%. Para una empresa con 80 leads al mes y un ticket medio de 8.000 euros, incluso una mejora del 10% en la tasa de conversión supone decenas de miles de euros anuales adicionales. Qué es un agente de IA y cómo se diferencia de una automatización clásica Una automatización clásica en n8n ejecuta reglas fijas: si llega un formulario, crea un contacto en el CRM y envía un correo de confirmación. Es útil, pero no interpreta contexto ni toma decisiones. Un agente de IA en n8n incorpora un modelo de lenguaje (por ejemplo, GPT-4o o Claude) que actúa como motor de razonamiento. El agente puede leer el correo entrante de un prospecto, extraer la industria, el tipo de solicitud y el nivel de urgencia, consultar el CRM para ver si ya existe una relación previa, redactar una respuesta personalizada, actualizar el registro en HubSpot o Zoho con los datos extraídos y, según la puntuación asignada, escalar al comercial asignado o iniciar un flujo de nurturing automático. Esa diferencia se traduce en autonomía operativa: mientras la automatización clásica se limita a ejecutar reglas predefinidas, el agente incorpora una capa de razonamiento que evalúa el contexto de cada caso y determina el paso siguiente. En n8n, esta lógica se construye combinando nodos de AI Agent, herramientas conectadas como HTTP Request, Gmail o Outlook, y conectores nativos con CRMs como HubSpot, Zoho CRM o Pipedrive. Componentes técnicos de un stack funcional: n8n (self-hosted o cloud): orquestador de workflows que conecta todas las piezas sin requerir desarrollo a medida. Modelo de lenguaje (LLM): GPT-4o vía API de OpenAI o modelos open-source como Mistral, según el perfil de privacidad de datos. CRM: HubSpot, Zoho CRM o Pipedrive como sistema de registro de leads, etapas del pipeline y cotizaciones. Correo comercial: Gmail con OAuth2 o Microsoft 365 vía conectores nativos de n8n para lectura y envío de correos. Base de conocimiento: un documento en Notion, Google Docs o una base de datos PostgreSQL con tarifas, catálogos y condiciones comerciales que el agente consulta para generar propuestas. Esta arquitectura no requiere un equipo de ingeniería propio. Una organización con acceso a un consultor especializado puede tener un piloto funcional en cuatro a seis semanas. Flujo práctico: de la entrada del lead a la cotización enviada sin intervención humana El siguiente flujo representa un caso típico en una empresa de servicios profesionales B2B con ciclos de venta de 15 a 60 días: Paso 1: Captura y clasificación del lead. El agente monitoriza en tiempo real una bandeja de entrada de Gmail o Outlook configurada como buzón comercial. Al detectar un nuevo correo o la entrada de un formulario web (Typeform, formulario de HubSpot), extrae mediante el LLM los campos clave: empresa, sector, necesidad expresada, urgencia percibida y datos de contacto. Clasifica el lead en frío, templado o caliente según criterios definidos por el equipo comercial. Paso 2: Registro y enriquecimiento en el CRM. El agente crea o actualiza automáticamente el registro en HubSpot o Zoho CRM, asigna la etapa del pipeline correcta y, si procede, conecta con una API de enriquecimiento como Clearbit o Apollo para añadir datos firmográficos (tamaño de empresa, sector, facturación estimada). Este paso, que manualmente consume entre cinco y diez minutos por lead, se ejecuta en menos de 30 segundos. Paso 3: Respuesta inicial personalizada. Para leads calificados, el agente redacta y envía en menos de cinco minutos un correo de respuesta en nombre del comercial asignado. El mensaje incluye referencias específicas al
Agentes de IA en empresas de EE. UU. 2026: análisis comparativo por sector
Agentes de IA en pequeñas y medianas empresas de EE. UU. 2026: análisis comparativo por sector El 88% de los equipos comerciales en EE. UU. ya utiliza alguna forma de inteligencia artificial, pero solo el 4% cuenta con datos suficientemente limpios para que esa IA funcione de manera confiable (Gartner/McKinsey, 2026). Esa brecha entre adopción declarada y valor real generado define el panorama actual de la automatización en las empresas del mercado norteamericano. Este artículo analiza dónde está la madurez real por sector, qué errores concentran el riesgo y qué patrones distinguen a las organizaciones que ya obtienen resultados medibles. El contexto macro: adopción alta, resultados desiguales El mercado de agentes de ventas con IA pasará de 4,4 mil millones de dólares en 2025 a una estimación de entre 15 y 18 mil millones para 2030, con una tasa de crecimiento anual compuesta cercana al 46%. El capital de riesgo respalda esa proyección: startups como 11x.ai, especializada en agentes SDR autónomos, levantó 76 millones de dólares en los últimos 18 meses; Regie.ai, enfocada en secuencias outbound personalizadas con IA, acumula 50,8 millones de dólares en financiación. Sin embargo, Gartner proyecta que más del 40% de los proyectos de IA iniciados en 2025 y 2026 se cancelarán antes de llegar a producción, principalmente por problemas de calidad de datos y expectativas mal calibradas. Para la dirección de TI y operaciones en una empresa, ese dato no es una advertencia abstracta; es el escenario más probable si no se establece una base de datos gobernada antes de activar agentes. Takeaway: La aceleración del mercado no implica que cualquier implementación produzca retorno. El diferenciador no es acceder a la tecnología, sino tener datos operativos confiables sobre los cuales ejecutarla. Sector SaaS: alta experimentación, gobernanza pendiente Las empresas de software con entre 50 y 500 empleados concentran la mayor densidad de pilotos activos de agentes de IA en EE. UU. Los casos más frecuentes incluyen: Calificación y enriquecimiento de leads mediante agentes conectados a HubSpot o Salesforce, que analizan señales de intención y actualizan el scoring de cuentas sin intervención manual. Secuencias outbound generadas por IA usando plataformas como Regie.ai, donde los agentes redactan y ajustan mensajes multicanal según el segmento ICP. Soporte nivel 1 automatizado con agentes conversacionales entrenados sobre documentación de producto, integrados al sistema de tickets vía n8n o Zapier. Resumen automático de llamadas comerciales con herramientas como Gong o Fireflies.ai, vinculadas al CRM para actualizar registros de oportunidades. El problema recurrente no es la tecnología sino los datos. La mayoría de los equipos descubren durante el piloto que sus registros de CRM tienen duplicados, campos vacíos o historiales incompletos que degradan la calidad de las salidas del agente. Cuando el modelo recibe datos sucios, genera recomendaciones inexactas; el equipo pierde confianza y el proyecto se archiva antes de llegar a producción, replicando exactamente la estadística de Gartner. Takeaway: En SaaS, el ROI de los agentes depende directamente de la higiene del CRM. Antes de activar cualquier agente SDR o scoring automatizado, un sprint de auditoría y limpieza de datos en HubSpot o Salesforce reduce el riesgo de cancelación en producción de forma significativa. Sector logística: automatización de back-office con mayor tracción En logística, las empresas han encontrado mayor valor en la automatización de procesos operativos internos que en agentes de cara al cliente. Los flujos con mayor adopción incluyen: Extracción y procesamiento de documentos (órdenes de compra, remitos, facturas de proveedores) usando RPA combinado con modelos de procesamiento de lenguaje natural, orquestados mediante n8n. Conciliación automática de facturación y pagos, donde agentes cruzan datos entre el sistema ERP, el portal bancario y las plataformas de carriers sin intervención del equipo financiero. Agentes de atención a clientes para consultas de estado de envío, gestión de incidencias y apertura de reclamaciones, disponibles por chat y voz fuera del horario laboral. Predicción básica de demanda para reposición de inventario, usando modelos entrenados sobre histórico de órdenes exportado desde el ERP. La logística tiene una ventaja estructural respecto a SaaS: sus datos operativos tienden a ser más estructurados y transaccionales, lo que facilita que los agentes y los flujos RPA produzcan resultados consistentes desde etapas tempranas. El punto débil habitual es la integración con sistemas legados; muchos carriers y plataformas de gestión de almacén exponen APIs limitadas, lo que obliga a diseñar conectores personalizados en n8n antes de poder orquestar procesos extremo a extremo. Takeaway: En logística, priorizar la automatización del back-office sobre los agentes conversacionales frontales produce retorno más rápido y con menor riesgo. El paso crítico previo es mapear qué sistemas tienen APIs accesibles y cuáles requieren integración por scraping estructurado o RPA de interfaz. Servicios profesionales: agentes como soporte al equipo, no como reemplazo Consultoras, agencias creativas y despachos de servicios especializados han encontrado en los agentes de IA una forma de aumentar la capacidad de sus equipos sin ampliar la nómina. Los patrones más consolidados son: Agentes internos tipo «analista junior» que sintetizan informes de mercado, generan borradores de propuestas comerciales y preparan briefings previos a reuniones de cliente a partir de datos del CRM y fuentes externas. Resumen automático de reuniones con extracción de compromisos y tareas, enviado a los involucrados por Slack o email mediante flujos en n8n conectados a herramientas como Notion o ClickUp. Account managers digitales de bajo riesgo: agentes externos que responden preguntas frecuentes, informan el estado de proyectos en curso y coordinan la agenda de revisiones sin consumir tiempo del equipo senior. Filtrado inteligente de solicitudes entrantes, donde el agente clasifica y prioriza consultas por tipo, urgencia y cliente, antes de que lleguen a un humano. El riesgo más frecuente en este sector es el de implementar agentes sobre procesos todavía no estandarizados. Cuando las propuestas se estructuran de forma diferente según el consultor, o cuando los criterios de calificación de clientes varían entre socios del despacho, el agente amplifica la inconsistencia en lugar de resolverla. La estandarización mínima del proceso debe preceder a la automatización. Takeaway: En servicios profesionales, el mayor retorno
Finalizamos una nueva capacitación en Power BI junto a AUSA
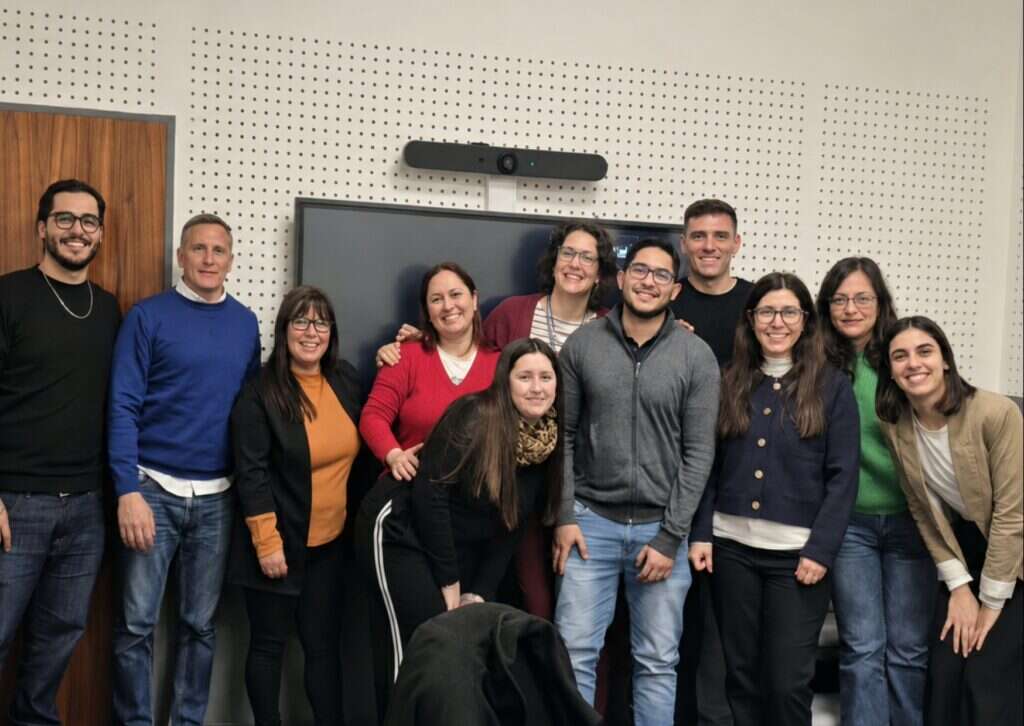
Finalizamos una nueva capacitación en Power BI junto a AUSA En WaveBI finalizamos una nueva capacitación en Microsoft Power BI junto al equipo de AUSA, orientada a fortalecer sus conocimientos y capacidades para el análisis y la gestión de datos. A lo largo del curso compartimos herramientas y conocimientos para acompañar a los participantes en el uso de Power BI y optimizar el uso de la información dentro de la organización. Agradecemos a AUSA por confiar en WaveBI para llevar adelante esta instancia de formación, y especialmente a Barbara Di Renzo y Martín Sánchez ,integrantes de nuestro equipo, por compartir sus conocimientos y acompañar a los participantes durante toda la capacitación. Felicitamos a todo el equipo que formó parte de esta experiencia. ¿Le gustaría fortalecer las capacidades de su equipo?Conozca nuestras capacitaciones para empresas y encuentre la propuesta que mejor se adapte a las necesidades de su organización. Conozca nuestras capacitaciones
Analítica de datos para PYME argentinas en 2026: ERP, Excel y Power BI con n8n
Analítica de datos para PYME argentinas en 2026: ERP, Excel y Power BI con n8n El 44% de las PYME argentinas ya usa algún tipo de dashboard o analítica básica, según relevamiento de la Secretaría de Industria y Desarrollo Productivo. Ese número subió 13 puntos porcentuales desde 2021. Sin embargo, la brecha entre «tener Power BI instalado» y «tomar decisiones con datos en menos de dos horas» sigue siendo enorme para la mayoría de los equipos de operaciones. Este artículo desglosa la arquitectura práctica que cierra esa brecha, sin data warehouses en la nube ni presupuestos en dólares. El contexto económico que define las decisiones de arquitectura en 2026 Con un PIB proyectado para crecer 5% y una inflación anual estimada en 10,1% según proyecciones oficiales, el contexto de 2026 combina recuperación con presión sostenida sobre los costos. Al mismo tiempo, el recorte acumulado de 46,4% en financiamiento público a Ciencia y Técnica entre 2023 y 2026 deja a las PYME sin subsidios ni programas que antes amortiguaban la inversión en software. La consecuencia directa: cada peso invertido en analítica tiene que justificarse con resultados medibles, y las arquitecturas que dependen de licencias en dólares (Azure Synapse, Databricks, Snowflake) quedan fuera del alcance real para la mayoría. La arquitectura que describimos a continuación responde a esa restricción sin sacrificar funcionalidad operativa. El principio central es aprovechar lo que ya existe: el ERP on-premise, los archivos Excel en el servidor de archivos o SharePoint, y las licencias Power BI Pro que muchos equipos ya tienen pero subutilizan. Los tres componentes de la arquitectura «low cost» que funciona 1. ERP como fuente única de verdad operativa En las PYME B2B argentinas de 50 a 500 empleados, los ERP más frecuentes son Tango Gestión, Bejerman, Restô y, en empresas más grandes, SAP Business One. Todos exponen datos de dos formas: mediante base de datos SQL Server directa (la más común) o mediante APIs REST propietarias (disponibles en versiones más recientes de Tango y algunas integraciones de Bejerman). El error más frecuente en esta capa es intentar conectar Power BI directamente al ERP con consultas en tiempo real sin ningún buffer. Eso genera tres problemas concretos: bloqueos en la base productiva, tiempos de carga superiores a 10 minutos en modelos grandes, y dependencia total de que el ERP esté disponible cuando alguien refresca el informe. La solución correcta es siempre una capa intermedia, aunque sea mínima: una base SQL separada, un conjunto de tablas espejo, o incluso archivos CSV programados que actúen como staging área. Takeaway: nunca conectés Power BI directo a la base productiva del ERP. Usá una réplica, un schema separado o una extracción programada como buffer. 2. Excel como capa de trabajo, no como fuente de datos caótica Excel no desaparece en esta arquitectura; se le asigna un rol específico y controlado. Las PYME usan Excel para tres cosas legítimas: carga manual de datos que el ERP no captura (presupuestos comerciales, metas por vendedor, costos de logística variables), conciliaciones temporales durante cierres de mes, y plantillas de entrada para áreas que no tienen acceso al ERP. El problema surge cuando Excel también actúa como fuente de reportes ejecutivos sin control de versiones ni validación. En ese escenario, el director comercial trabaja con una planilla y el CFO con otra; los números no coinciden y la reunión de dirección se convierte en un debate sobre qué archivo es «el correcto». La práctica que funciona es centralizar todos los archivos Excel en una carpeta de SharePoint o en una ruta de red con permisos estrictos, nombrar los archivos con convención fija (por ejemplo: ventas_consolidado_YYYYMM.xlsx), y designar una persona responsable de cada archivo. Power BI lee esas rutas fijas; si el archivo no está en el lugar correcto, el refresh falla y eso actúa como alerta temprana. El caos de Excel no se resuelve eliminando Excel; se resuelve gobernándolo. Takeaway: definí una convención de nombres, una carpeta única en SharePoint o file server, y un responsable por archivo. Eso es el 80% de la gobernanza que necesita una PYME. 3. n8n como orquestador ETL liviano en VPS n8n es una herramienta de automatización de flujos open source que se puede instalar en un VPS local o en la nube por menos de 20 dólares mensuales. En la arquitectura que describimos, n8n reemplaza los scripts de PowerShell o los jobs de SQL Agent que muchos equipos de TI mantienen manualmente y que nadie documenta. Un flujo típico en n8n para una PYME industrial tiene esta secuencia: Trigger programado: se ejecuta todos los días a las 6:00 AM. Nodo HTTP Request o SQL: lee ventas del día anterior desde el schema de réplica del ERP (Tango o Bejerman vía SQL Server). Nodo Transform: aplica lógica de negocio simple, por ejemplo calcular margen bruto o agrupar por zona geográfica. Nodo Write File o SharePoint: actualiza el archivo Excel centralizado o escribe directamente en una tabla SQL intermedia. Nodo HTTP Request a Power BI API: llama al endpoint de refresh del dataset para que Power BI actualice el modelo sin intervención manual. Este flujo exacto fue implementado por una PYME industrial de Córdoba que en 2024 redujo el tiempo de armado de informes comerciales semanales de 2 días a menos de 2 horas. La orquestación completa corrió en n8n sobre un VPS, sin ningún servicio de nube adicional. Takeaway: n8n instalado en un VPS de 20 dólares mensuales reemplaza entre 3 y 5 scripts manuales no documentados y agrega trazabilidad de errores que los scripts nunca tuvieron. Power BI: configuración correcta para el contexto argentino Gateway on-premise: el componente que más se subestima El Power BI On-Premises Data Gateway es el software que permite que el servicio en la nube de Power BI (powerbi.com) acceda a fuentes de datos locales: SQL Server del ERP, archivos Excel en el servidor de archivos, bases de datos Access. Sin gateway, un modelo Power BI Pro no puede refrescarse automáticamente si los datos están en la red interna. Los errores más
Data Mart Analítico para Pymes Exportadoras Argentinas: Modelo Técnico Paso a Paso

Data Mart Analítico para Pymes Exportadoras Argentinas: Modelo Técnico Paso a Paso El 73% de las pymes exportadoras argentinas toma decisiones de margen sin datos consolidados Según datos de la Encuesta INTI-Fundación Exportar 2023, solo alrededor del 27% de las pymes exportadoras argentinas declara usar herramientas formales de analytics para gestión financiera y de márgenes. Eso significa que casi tres de cada cuatro organizaciones operan con reportes mensuales estáticos en Excel, sin visibilidad en tiempo real sobre cómo el tipo de cambio está erosionando sus márgenes en cada operación. En un contexto donde más del 60% de las pymes exportadoras cita la volatilidad FX como su principal factor de riesgo (BCRA/CEPAL 2022-2023), esa brecha de información tiene un costo directo y medible. Este artículo describe, paso a paso, cómo diseñar un data mart analítico mínimo viable (DMAMV) orientado a tres dimensiones críticas para cualquier exportadora argentina: márgenes por producto y mercado, exposición al tipo de cambio, y cash flow proyectado. El modelo técnico es deliberadamente pragmático: pensado para organizaciones que ya usan un ERP contable local (Tango, Bejerman o Colppy) y quieren pasar de la hoja de cálculo al análisis estructurado sin un proyecto de dos años. Qué es un data mart analítico mínimo viable y por qué no es un data warehouse Un data warehouse centraliza toda la información de la organización en un modelo unificado. Un data mart temático es una vista analítica enfocada en un dominio específico: en este caso, finanzas de exportación. La diferencia importa porque condiciona el tiempo y presupuesto de implementación. El DMAMV que describimos acá tiene tres tablas de hechos principales y no más de ocho dimensiones. Corre en la nube (BigQuery o Snowflake en su tier gratuito o de bajo costo son opciones válidas), se alimenta de tres fuentes de datos y se visualiza en Power BI Desktop conectado al cloud. El objetivo no es construir la arquitectura perfecta; es tener los primeros KPIs confiables operando en cuatro a seis semanas. Takeaway: un data mart temático bien diseñado resuelve el 80% de las preguntas analíticas críticas con el 20% del esfuerzo de un warehouse completo. Empezá por ahí. Arquitectura técnica: las tres capas del modelo Capa 1: Ingesta y staging Las fuentes de datos típicas en una pyme exportadora argentina son fragmentadas por diseño: el ERP contable (Tango Gestión o Bejerman) exporta archivos DBF o CSV; los bancos entregan extractos en XLS o TXT; el sistema de comercio exterior (despachante, Aduana en línea) genera PDFs o tablas HTML; y las cotizaciones FX se obtienen de scraping del BCRA o del Banco Nación. A esto se suma la operatoria con tipos de cambio paralelos (MEP, CCL) que las áreas financieras suelen registrar manualmente. Para la capa de staging recomendamos Airbyte (open source) o Fivetran para fuentes con conector disponible, complementado con scripts Python para las fuentes no estándar. Un caso de referencia concreto: un proyecto académico sobre retail pyme en Argentina demostró que es perfectamente viable construir un data mart a partir de Excel, PDFs de AFIP y web scraping, usando Python para el ETL y cargando en un modelo estrella en PostgreSQL. El patrón es directamente trasladable a exportadoras B2B. El landing zone inicial puede ser tan simple como un bucket en AWS S3 o Google Cloud Storage, con archivos particionados por fecha y fuente. No necesitás Kafka ni streaming en esta etapa. Capa 2: Modelo dimensional El corazón técnico del DMAMV es un modelo estrella con las siguientes tablas de hechos: fact_ventas_export: importe en USD/EUR, importe en ARS al tipo de cambio oficial y al tipo de cambio de liquidación efectiva, costo de producción en ARS, margen bruto en moneda dura y en pesos. fact_cobros_fx: fecha de cobro, importe cobrado, tipo de cambio aplicado (oficial, MEP, CCL), diferencia cambiaria respecto al tipo de cambio de la factura original, banco, método de ingreso de divisas. fact_cashflow_proyectado: fecha de vencimiento estimado, importe proyectado en USD, escenario de tipo de cambio (base, optimista, estresado), importe convertido por escenario. Las dimensiones clave son: dim_cliente (país, segmento, canal), dim_producto (familia, línea, costo estándar), dim_moneda (código ISO, tipo de cambio vigente por fecha), dim_tiempo (fecha, semana, mes, trimestre, año fiscal), y dim_escenario_fx (tipo de cambio oficial, MEP, CCL, proyectado a 90 días). Este diseño le permite a Power BI calcular en DAX métricas como el margen ajustado por tipo de cambio de liquidación real, la brecha porcentual entre tipo de cambio oficial y efectivo, y el cash flow proyectado bajo tres escenarios de devaluación sin necesidad de fórmulas manuales en Excel. Capa 3: Visualización y KPIs en Power BI Con el modelo dimensional cargado en BigQuery o Snowflake, Power BI se conecta en modo DirectQuery o con importación programada (recomendamos importación nocturna para pymes con volúmenes menores a 5 millones de filas). Los tres tableros mínimos viables son: Tablero de márgenes: margen bruto por producto y mercado en USD, margen ajustado por tipo de cambio de liquidación, ranking de clientes por rentabilidad real. Tablero FX: brecha cambiaria histórica (oficial vs. MEP vs. CCL), impacto acumulado en márgenes, alerta por operación con brecha superior al umbral definido por la dirección. Tablero de cash flow: flujo proyectado a 30, 60 y 90 días por escenario de tipo de cambio, cobertura de obligaciones en pesos, alerta de liquidez bajo escenario de estrés. Takeaway: el modelo estrella con tres tablas de hechos y cinco dimensiones es suficiente para responder las preguntas más críticas de la dirección financiera de una exportadora argentina. No agregues complejidad hasta que el modelo base esté validado con los usuarios. Implementación paso a paso: de cero a los primeros datos en cuatro semanas Semana 1: relevamiento y mapeo de fuentes Identificá todas las fuentes de datos existentes: ERP, bancos, sistemas de comercio exterior, planillas FX manuales. Documentá el formato de salida de cada una (CSV, DBF, XLS, API REST, PDF). En esta etapa, el objetivo no es integrar nada; es entender qué datos existen, con qué frecuencia se actualizan y quién los produce. El resultado es
IA y plataformas analíticas: qué necesitan las empresas para competir en 2026
IA y plataformas analíticas: qué necesitan las empresas para competir en 2026 El mercado ya no espera: la IA escala a 196.630 millones de dólares y las plataformas analíticas son el cuello de botella El mercado global de inteligencia artificial cerró 2024 en 196.630 millones de dólares, con una proyección de crecimiento superior a 13 veces para 2030 a una tasa anual compuesta de entre 36% y 38% (fuente: análisis de mercado 2024). Solo en Estados Unidos, ese mercado alcanzará los 299.640 millones de dólares en 2026. La pregunta que tenían muchas organizaciones hace dos años, «¿deberíamos probar IA?», está resuelta. La pregunta de 2026 es más exigente: ¿tiene su empresa la infraestructura analítica para que la IA funcione sobre datos reales, gobernados y actualizados? La respuesta honesta, para la mayoría de las PYME, es que no. Y ese es precisamente el reto que define la agenda tecnológica de este año. Qué cambió: del dashboard estático al agente que analiza y decide Durante años, el objetivo de una plataforma analítica era claro: consolidar datos, visualizarlos en un dashboard y permitir que un analista interpretara los números. Ese modelo no desapareció, pero quedó relegado a una función auxiliar. Lo que se consolida en 2026 es un paradigma distinto, donde la plataforma analítica actúa como capa de inteligencia activa. De BI descriptivo a analítica aumentada por IA Las plataformas de referencia, como Microsoft Fabric con Copilot o el ecosistema Databricks Lakehouse, ya no separan el almacenamiento de datos del modelado predictivo ni de la generación de insights. Un único prompt puede desencadenar la preparación de datos, el análisis estadístico y la explicación en lenguaje natural de una anomalía en ventas o en la cadena de suministro. La separación tradicional entre el equipo de datos y el usuario de negocio se adelgaza de forma concreta. Esto no es un avance incremental. Es un cambio estructural en cómo se produce el conocimiento empresarial. La consecuencia práctica para la dirección de TI es que mantener una arquitectura basada exclusivamente en hojas de cálculo, informes estáticos de Power BI desconectados del origen o bases de datos en silos representa hoy un riesgo operativo medible, no solo una deuda técnica. El tiempo real deja de ser opcional El análisis de datos en tiempo real se consolida como una de las tendencias críticas para 2026, especialmente en operaciones y experiencia de cliente. La lógica es directa: si un agente de IA necesita intervenir antes de que un problema ocurra, ya sea una ruptura de stock, una fuga de clientes o una desviación presupuestaria, necesita datos frescos, no reportes del día anterior. Las organizaciones que aún operan con ETL nocturnas y actualizaciones manuales de KPIs no están en condiciones de aprovechar los casos de uso de IA con mayor retorno. El desfase entre el dato y la decisión ya no se mide en horas; se mide en oportunidades perdidas. Low-code y gobernanza: la combinación que define el estándar Las plataformas low-code y no-code para análisis de negocio, como Power BI o las interfaces de lenguaje natural sobre Databricks, han dejado de ser alternativas económicas para convertirse en el estándar de facto en finanzas, marketing e I+D de empresas en crecimiento. Sin embargo, el informe Data, Analytics and AI 2026 del SDG Group identifica un riesgo específico: la democratización del acceso sin gobernanza produce proliferación de métricas inconsistentes y pérdida de confianza en los datos. Gobernanza, calidad de datos y contexto de negocio son los tres ejes que determinan si la IA produce resultados confiables o simplemente genera respuestas rápidas que nadie puede validar. La velocidad sin estructura no es madurez analítica; es ruido operativo. Por qué importa especialmente en el mercado latinoamericano y español En España, la inversión proyectada en IA asciende a 1.400 millones de euros en 2025 con un crecimiento anual del 27%. Parte de esa inversión está vinculada a subvenciones, fondos europeos y programas públicos que exigen evidencia de madurez digital para acceder a financiamiento. Las PYME que no modernizaron su plataforma de datos analíticos no solo pierden ventaja competitiva; en muchos casos pierden elegibilidad directa para las ayudas disponibles. Para el mercado latinoamericano, el argumento es diferente pero igual de urgente. La presión competitiva de corporaciones que ya despliegan agentes de IA sobre plataformas consolidadas crea una brecha de eficiencia que los equipos de operaciones sienten en ciclos de cierre, en tiempos de respuesta a clientes y en la capacidad de tomar decisiones basadas en datos, no en intuición. Los retos reales para empresas de 50 a 500 empleados Hablar de plataformas como Microsoft Fabric o Databricks es útil para entender hacia dónde va el mercado. Pero la realidad operativa de una PYME con presupuesto limitado y equipos pequeños de TI tiene sus propias fricciones específicas. Fragmentación y calidad de datos: el costo real antes de implementar IA El obstáculo más frecuente no es la falta de tecnología; es la dispersión de datos en hojas de cálculo de Excel, archivos PDF, sistemas ERP desactualizados como versiones antiguas de SAP o plataformas de CRM sin integración. Limpiar, estandarizar y centralizar esos datos antes de entrenar o consumir cualquier modelo de IA tiene un costo real en tiempo y recursos que muchas organizaciones subestiman hasta que ya están comprometidas con una implementación. El resultado es predecible: proyectos de IA que arrancan, se frenan por problemas de datos y pierden impulso interno. No es un problema tecnológico; es un problema de secuencia. La plataforma analítica no puede ser el segundo paso. Falta de una capa semántica compartida Cuando el equipo comercial mide «ingresos» de forma diferente al equipo financiero, ningún agente de IA va a resolver esa contradicción por sí solo. La ausencia de una capa semántica compartida, es decir, una definición única y centralizada de KPIs críticos como margen, tasa de conversión o costo por adquisición, produce inconsistencias que invalidan los outputs de cualquier modelo. Invertir en IA sin resolver esto primero es trasladar el problema, no eliminarlo. Qué deben hacer los directivos ahora: tres acciones
Protocolo MCP y Power BI: caso de uso en empresas mexicanas
El protocolo MCP no es magia: es una interfaz técnica con límites muy concretos
Antes de invertir tiempo o presupuesto en implementar Model Context Protocol (MCP) dentro de su ecosistema de Power BI,…